第 8 章 基于混淆电路的协议
与基于秘密分享的方案不同,混淆电路是安全多方计算的另一种经典方法。它最早由图灵奖得主姚期智院士在1986年提出,该协议被称为姚氏混淆电路协议 [Yao, 1986](Yao's Garbled Circuits protocol, Yao's GC)。它是第一个通用两方安全计算协议,并成为了安全多方计算迅速发展的开端。
本章,我们首先介绍姚氏两方混淆电路协议。在进行安全性分析时,我们会发现姚氏混淆电路协议的原始版本并不满足通用可组合安全。因此,我们将介绍独立(stand-alone)模型,并介绍独立模型与通用可组合模型之间的关系,然后在独立模型下对姚氏混淆电路协议进行安全性证明。随着安全多方计算的发展,研究者提出了许多混淆电路的优化构造,本章我们也将介绍其中的几个经典方案。
最后,在「BMR协议」一节,我们介绍BMR协议 [Bea et al., 1990],它将姚氏混淆电路协议拓展到多方的场景,是基于混淆电路的多方计算方案。
姚氏混淆电路协议
直观思想
计算一个与门。我们先考虑一个最简单的情况。\(P_1\) 和 \(P_2\) 分别拥有一比特的输入 \(x\) 和 \(y\),\(x, y \in \{0, 1\}\). 他们想要计算 \(z = x \wedge y\),即计算一个与门(例如,「安全乘法与配对」一节中的配对场景)。那么,输入和输出满足如表 8.1所示的真值表。
| 0 | 1 | 0 |
| 1 | 0 | 0 |
| 1 | 1 | 1 |
与门的真值表
参与双方不能泄露自己的输入,因此不能直接把输入发给对方。混淆电路的直观思想是:为每个输入的每个可能取值选择一个随机密钥,用对应的密钥加密输出值。具体而言,对于 \(x\) 的可能取值 0 和 1,随机选择两个密钥 \(k_X^0\) 和 \(k_X^1\);同样地,对于 \(y\) 的可能取值 0 和 1,随机选择两个密钥 \(k_Y^0\) 和 \(k_Y^1\). 然后根据真值表,用对应的密钥加密输出 \(z\). 于是,我们得到如表 8.2所示的加密后的真值表。
| \(k_X^0\) | \(k_Y^1\) | \(\mathsf{Enc}_{k_X^0}( \mathsf{Enc}_{k_Y^1}(0) )\) |
| \(k_X^1\) | \(k_Y^0\) | \(\mathsf{Enc}_{k_X^1}( \mathsf{Enc}_{k_Y^0}(0) )\) |
| \(k_X^1\) | \(k_Y^1\) | \(\mathsf{Enc}_{k_X^1}( \mathsf{Enc}_{k_Y^1}(1) )\) |
与门加密后的真值表
不妨假设 \(P_1\) 为每个输入随机选取了密钥,然后计算了表 \(T = [ \mathsf{Enc}_{k_X^0}( \mathsf{Enc}_{k_Y^0}(0) ), \mathsf{Enc}_{k_X^0}( \mathsf{Enc}_{k_Y^1}(0) ), \mathsf{Enc}_{k_X^1}( \mathsf{Enc}_{k_Y^0}(0) ), \mathsf{Enc}_{k_X^1}( \mathsf{Enc}_{k_Y^1}(1) ) ]\). \(P_1\) 将表 \(T\) 打乱顺序(也就是进行随机排列)得到 \(T'\),并将 \(T'\) 发送给 \(P_2\). 那么,如果 \(P_2\) 拥有了 \(x\) 和 \(y\) 的一组密钥,那么他就可以正确解密 \(T'\) 中对应的那项,得到输出 \(z\);而对于 \(T'\) 中的其他项,解密结果是乱码(或错误)。
现在我们面临的问题就是:如何让 \(P_2\) 拥有输入 \(x\) 和 \(y\) 所对应的密钥?显然,\(P_1\) 知道自己的输入 \(x\),如果 \(x = 0\),那就把 \(k_X^0\) 发送给 \(P_2\),如果 \(x = 1\),那就发送 \(k_X^1\). 因为 \(k_X^0\) 和 \(k_X^1\) 都是随机选的值,这一步不会泄露输入 \(x\). 但是,\(P_1\) 不知道 \(P_2\) 的输入 \(y\),要怎么让 \(P_2\) 得到 \(y\) 的对应密钥呢?方法是运行OT协议(其定义和构造参见「茫然传输」一节和第5章),\(P_1\) 作为发送方,以 \(k_Y^0, k_Y^1\) 作为输入;\(P_2\) 作为接收方,以 \(y\) 作为输入。那么,协议结束后 \(P_2\) 就得到了 \(y\) 的对应密钥 \(k_Y^y\),而 \(P_1\) 不知道 \(P_2\) 的输入 \(y\),\(P_2\) 也不知道 \(y\) 的另一个密钥。最后,\(P_2\) 尝试解密 \(T'\) 中的每一项,正确解密的结果即为 \(z\). \(P_2\) 再将 \(z\) 发送给 \(P_1\) 以完成协议。
不难看出,这样构造的协议满足正确性。让我们分析一下隐私性。从 \(P_1\) 的视角看,他只在OT协议中接收了 \(P_2\) 的消息(除去最后一步接收协议的输出 \(z\)),而OT协议的安全性保证了 \(P_1\) 不知道 \(P_2\) 的输入 \(y\). 从 \(P_2\) 的视角看,他接收到了表 \(T'\) 以及 \(x\) 的对应密钥,并且他从OT协议中获得了 \(y\) 的对应密钥。刚才分析过,\(x\) 的对应密钥不会泄露 \(x\),OT协议确保了 \(P_2\) 只能获得 \(y\) 的一个密钥,那么,\(P_2\) 只能正确解密 \(T'\) 中的一项,加密方案的安全性保证了 \(P_2\) 不能从 \(T'\) 中的另外三项获得任何信息(注:这里我们稍微有一点不严谨,我们说对 \(T'\) 的另外三项进行解密会得到乱码或错误,但加密方案的定义并不天然地保证这一点。之后的章节会有这个性质的形式化定义。)。
将函数表示为查找表。基于上述思想,我们可以将任意函数表示为查找表(真值表),然后为每一个可能的输入值选取随机密钥,将输出值加密。具体而言,假设参与方 \(P_1\) 和 \(P_2\) 想要计算函数 \(z = f(x, y)\),其中 \(P_1\) 的输入为 \(x\),\(P_2\) 的输入为 \(y\). 设 \(x\) 的取值范围为 \(X\), \(y\) 的取值范围为 \(Y\). 对于每一个可能的取值 \(x \in X\),\(P_1\) 选取随机密钥 \(k_X^x\);同样地,对于每一个可能的取值 \(y \in Y\),选取随机密钥 \(k_Y^y\). 然后,用 \(k_X^x\) 和 \(k_Y^y\) 加密 \(f(x, y)\),即 \(\mathsf{Enc}_{k_X^x}(\mathsf{Enc}_{k_Y^y}(f(x, y)))\). \(P_1\) 将这张表(大小为 \(|X| \cdot |Y|\))随机排列后发送给 \(P_2\),并且将自己的输入 \(x\) 对应的密钥 \(k_X^x\) 一并发送,然后双方执行1-out-of-\(|Y|\) OT协议使 \(P_2\) 获得输入 \(y\) 所对应的密钥。最后,\(P_2\) 尝试解密表中的每一项(注:这里我们暂时粗略地假设输出 \(z\) 的可能取值与解密其他项得到的乱码(或错误)是可以区分的。)得到输出 \(z\).
降低查找表的大小。上述朴素的方案只有当 \(x, y\) 的取值范围较小时才可行,如果 \(x, y\) 的取值范围较大,例如,\(x, y\) 的长度均为64比特,那么加密后的查找表的大小为 \(|X| \cdot |Y| = 2^{64} \cdot 2^{64} = 2^{128}\). 计算这么大的查找表显然是不可行的。
如何有效地降低查找表的大小呢?这里的思路是:我们可以不通过一张(巨大的)查找表来计算函数 \(f\),而是将 \(f\) 转化为布尔电路,对布尔电路的每一个门计算一张(小)查找表。
让我们探讨一下如何让上述思路具体落地。也就是说,我们将函数 \(f\) 转化为了布尔电路,那么对于布尔电路的每一个门,应该如何构建查找表呢?注意,这里的情况与刚才有所不同。此时,查找表的输出应该是下一个布尔门的输入,而不是函数 \(f\) 的输出,也就是计算的中间结果,因此它也不能被泄露。方案不难想象:我们为布尔电路的每一条导线 \(w_i\) 随机选取密钥 \(k_i^0, k_i^1\),分别代表值为0和1. 对于输入导线为 \(w_a, w_b\),输出导线为 \(w_c\) 的布尔门,根据布尔门的真值表使用 \(w_a, w_b\) 对应的密钥来加密 \(w_c\) 的密钥。例如,对于与门而言,查找表如表 8.3所示。
| \(k_a^0\) | \(k_b^1\) | \(k_c^0\) | \(\mathsf{Enc}_{k_a^0}( \mathsf{Enc}_{k_b^1}(k_c^0) )\) |
| \(k_a^1\) | \(k_b^0\) | \(k_c^0\) | \(\mathsf{Enc}_{k_a^1}( \mathsf{Enc}_{k_b^0}(k_c^0) )\) |
| \(k_a^1\) | \(k_b^1\) | \(k_c^1\) | \(\mathsf{Enc}_{k_a^1}( \mathsf{Enc}_{k_b^1}(k_c^1) )\) |
与门的查找表
基于这样的构造,如果拥有了输入导线的一组密钥,就可以正确解密输出导线的对应密钥,然后再用这个密钥解密下一个门,从而计算整个电路。
哪个解密结果是正确的?细心的读者可能会发现:当尝试解密(随机排列后的)查找表的每一项时,得到的可能是正确的密钥,也可能是乱码。但是,正确的密钥也是随机选择的值,如何确定哪个解密结果是正确的密钥呢?
一个简单的方法是:在密钥后面添加 \(n\) 个0再进行加密,其中 \(n\) 为安全参数。那么,对于输入导线为 \(w_a, w_b\),输出导线为 \(w_c\) 的与门,查找表如表 8.4所示。
| \(k_a^0\) | \(k_b^1\) | \(k_c^0\) | \(\mathsf{Enc}_{k_a^0}( \mathsf{Enc}_{k_b^1}(k_c^0 || 0^n) )\) |
| \(k_a^1\) | \(k_b^0\) | \(k_c^0\) | \(\mathsf{Enc}_{k_a^1}( \mathsf{Enc}_{k_b^0}(k_c^0 || 0^n) )\) |
| \(k_a^1\) | \(k_b^1\) | \(k_c^1\) | \(\mathsf{Enc}_{k_a^1}( \mathsf{Enc}_{k_b^1}(k_c^1 || 0^n) )\) |
与门的查找表(添加 \(n\) 个0)
这样一来,解密其他项得到的乱码的最后 \(n\) 位恰好都是0的概率是可忽略的,我们可以确定:当解密结果的最后 \(n\) 位都是0时得到的就是正确的密钥。不过,这个解决方案是较为低效的,我们在「混淆电路的优化」一节将介绍更高效的方案。
协议描述(非形式化)。至此,我们可以总结一下姚氏混淆电路协议的流程。假设参与方 \(P_1\) 和 \(P_2\) 分别有 \(n\) 比特的输入 \(x\) 和 \(y\),\(x, y \in \{0, 1\}^n\). 他们想要计算函数 \(f(x, y)\),其输出也是 \(n\) 比特,即 \(f: \{0, 1\}^n \times \{0, 1\}^n \rightarrow \{0, 1\}^n\). 函数 \(f\) 已经转换为了等价的布尔电路 \(\mathcal{C}\).
\(P_1\) 为 \(\mathcal{C}\) 的每一条导线(注:如果某条导线同时充当多个地方的输入(例如,同时是多个门的输入导线,或同时是某个门的两条输入导线),那么我们将其视为一条导线。) \(w_i\) 随机选取密钥 \(k_i^0, k_i^1\). 然后根据布尔门的真值表,为每个布尔门按照上述方式计算查找表并进行随机排列。
\(P_1\) 将所有(随机排列后的)查找表发送给 \(P_2\). 对于每条输出导线,\(P_1\) 发送一张解密表,导线 \(w_i\) 的解密表包含 \((0, k_i^0)\) 和 \((1, k_i^1)\).(注:这里我们需要假设每条输出导线不是其他门的输入导线,否则 \(P_2\) 得到输出导线的两个密钥后可能会计算额外信息。如果电路 \(\mathcal{C}\) 不满足这个条件,我们可以在 \(z_i\) 输出之前增加一个与门 \(g_\mathsf{AND}(z_i, a)\),其中 \(a = 1\). 这最多让电路大小增加 \(n\).)
假设 \(x\) 对应的输入导线为 \(w_1, …, w_n\),\(P_1\) 将 \(x\) 对应的密钥 \(k_1^{x_1}, …, k_n^{x_n}\) 发送给 \(P_2\).
假设 \(y\) 对应的输入导线为 \(w_{n+1}, …, w_{2n}\). 对 \(i \in [n]\),\(P_1\) 与 \(P_2\) 执行1-out-of-2 OT,其中 \(P_1\) 为发送方,输入是 \((k_{n+i}^0, k_{n+i}^1)\),\(P_2\) 是接收方,输入是 \(y_i\).
\(P_2\) 通过依次解密每一个布尔门来解密整个电路。当 \(P_2\) 获得输出导线上的密钥时,根据解密表得到输出 \(z = f(x, y)\). \(P_2\) 将 \(z\) 发送给 \(P_1\).
这里,每个布尔门的(加密的)查找表被称为混淆表(garbled table),所有混淆表构成的整个电路被称为混淆电路(garbled circuit)。
协议描述
根据上面的直观思想,当 \(P_2\) 尝试解密混淆表时,如果使用了对应的密钥,那么一定会得到正确的结果;而如果使用的不是对应的密钥,那么实质上是用 \(k'\) 去解密用 \(k\) 加密的密文,我们说此时会得到随机乱码。但是根据加密方案的定义(参见「对称加密」一节),它需要满足正确性和选择明文攻击安全,这并不能天然地保证用一个密钥解密另一个密钥加密的密文会得到随机乱码(尽管大多数加密方案都满足这一点)。我们需要更形式化地定义这个性质。
本节的协议描述主要参照了Lindell和Pinkas的论文 [Lin & Pin, 2009]。
“特殊的”加密方案。为了使 \(P_2\) 能够正确地计算混淆电路,我们使用的加密方案需要满足两个额外的性质:(1) 用某个密钥加密的密文落在另一个密钥的密文空间的概率是可忽略的;(2) 已知密钥 \(k\),可以高效地验证一个密文是否在 \(k\) 的密文空间内。这两个性质的形式化定义如下。
其中 \(x \in \{0, 1\}^n, \; r \leftarrow \{0, 1\}^n\),\(x 0^n\) 表示 \(x\) 与 \(0^n\) 的连接(注:实际上,0的数量只需要达到 \(\omega(\log n)\) 即可(super-logarithmic),为了方便我们将它设置为 \(n\).)。
我们简要分析一下这个加密方案的性质:
不可知的密文空间(elusive range):如果PPT的敌手 \(\mathcal{A}\) 输出一个密文 \(c = \langle r, s \rangle \),它属于密文空间,这意味着解密结果 \(s \oplus f_k(r)\) 的最后 \(n\) 位都是0. 也就是说,敌手 \(\mathcal{A}\) 可以选择 \(r\),然后成功地预测 \(f_k(r)\) 的最后 \(n\) 位。因为 \(f_k\) 是伪随机函数,这在计算上是不可行的。
可验证的密文空间(efficiently verifiable range):给定密钥 \(k\) 和密文 \(c = \langle r, s \rangle \),只需验证 \(s \oplus f_k(r)\) 的最后 \(n\) 位是否均为0,如果是,那么 \(c \in \mathsf{Range}_{n}(k)\),否则 \(c \notin \mathsf{Range}_{n}(k)\).
选择明文攻击安全(IND-CPA secure,定义参见「对称加密」一节):对于两条不同的消息 \(x_0, x_1\),因为 \(f_k\) 是伪随机函数,所以 \(f_k(r) \oplus x_0 0^n\) 和 \(f_k(r) \oplus x_1 0^n\) 在计算上和随机数是不可区分的,故该加密方案是IND-CPA安全的。
可见,此加密方案满足定义 8.1所定义的性质。
在之前的直观描述中,混淆表的每一项都由两个密钥进行了双重加密。\(P_2\) 拥有一组密钥,他可以正确解密对应的那一项。我们必须确保另外三项不会泄露关于明文的任何信息。直观上看,这应该成立,因为每一项 \(P_2\) 都至少缺失了一个密钥。但是,我们需要形式化地证明这个性质。
与「形式化的定义」一节中类似,我们通过游戏(Game)来形式化地定义这个性质。令 \((\mathsf{Gen}, \mathsf{Enc}, \mathsf{Dec})\) 是一个对称加密方案。为了方便,我们定义符号 \(E(k_0, k_1, m) = \mathsf{Enc}_{k_0}(\mathsf{Enc}_{k_1}(m))\) 表示双重加密。我们有如下的双重加密安全游戏。
下面,我们证明任何选择明文攻击安全(IND-CPA secure)的加密方案都满足上面所定义的双重加密安全。它的证明需要用到以下结论:如果加密方案对一条消息满足选择明文攻击安全,那么对多条消息也满足选择明文攻击安全(证明可参见书 [Goldreich, 2004],Section 5.4)。这里,我们给出两条消息的选择明文攻击安全游戏,因为这已经足以证明我们的引理。
证明概要:这里,我们仅给出证明概要,根据证明概要很容易写出完整的证明。基本思路仍然是通过一系列混合游戏(hybrid game)来展示:当 \(b\) 等于0或1时,敌手 \(\mathcal{A}\) 在 \(\mathsf{Game}^\mathsf{double}_{\mathcal{A}}(n)\) 中的视图是不可区分的。
假设加密方案是IND-CPA安全的。首先,我们定义 \(\mathsf{Game}^\mathsf{mod}_{\mathcal{A}}(n)\),它与 \(\mathsf{Game}^\mathsf{double}_{\mathcal{A}}(n)\) 的不同之处在于无论 \(b\) 为何值,\(y_0\) 总是被加密,即 \(\mathcal{A}\) 总是收到 \(\langle E(k_0, k'_1, x_b), E(k'_0, k_1, y_0), E(k'_0, k'_1, z_b) \rangle\). 我们证明 \(\mathsf{Game}^\mathsf{mod}_{\mathcal{A}}(n)\) 与 \(\mathsf{Game}^\mathsf{double}_{\mathcal{A}}(n)\) 的视图是不可区分的:当 \(b = 0\) 时,两者完全相同;当 \(b = 1\) 时,这等价于区分 \(E(k'_0, k_1, y_0)\) 和 \(E(k'_0, k_1, y_1)\),因为 \(\mathcal{A}\) 不知道 \(k'_0\),根据单条消息的IND-CPA安全性,\(\mathcal{A}\) 无法区分它们。
接着,我们证明 \(\mathcal{A}\) 在游戏 \(\mathsf{Game}^\mathsf{mod}_{\mathcal{A}}(n)\) 获胜的概率不超过 \(\frac{1}{2} + \mathsf{negl}(n)\). 这里,我们假设 \(\mathcal{A}\) 可以知道 \(k'_0\).(注:\(\mathcal{A}\) 知道 \(k'_0\) 时结论成立,那么 \(\mathcal{A}\) 不知道 \(k'_0\) 时结论仍成立。) 因为 \(\mathcal{A}\) 总是收到 \(E(k'_0, k_1, y_0)\),这对区分 \(b=0\) 与 \(b=1\) 没有任何帮助,所以我们将其移除。此时,不难发现,如果 \(\mathcal{A}\) 在 \(\mathsf{Game}^\mathsf{mod}_{\mathcal{A}}(n)\) 中获胜,那么他也能在 \(\mathsf{Game}^\mathsf{CPA}_{\mathcal{A}}(n)\) 中获胜(因为 \(\mathcal{A}\) 知道 \(k_0, k'_0\),他可以将 \(\langle E(k_0, k'_1, x_b), E(k'_0, k'_1, z_b) \rangle\) 做一层解密,此时得到的就是 \(\mathsf{Game}^\mathsf{CPA}_{\mathcal{A}}(n)\) 中的视图)。由于加密方案是IND-CPA安全的,所以\(\mathcal{A}\) 在 \(\mathsf{Game}^\mathsf{mod}_{\mathcal{A}}(n)\) 获胜的概率也不超过 \(\frac{1}{2} + \mathsf{negl}(n)\).
综合以上两个结论可知,加密方案 \((\mathsf{Gen}, \mathsf{Enc}, \mathsf{Dec})\) 具有双重加密安全。 □
混淆电路的构造。在正式描述姚氏混淆电路协议之前,我们先形式化地介绍混淆电路的构造方式。令 \(\mathcal{C}\) 是一个布尔电路,它的输入是 \(x, y \in \{0, 1\}^n\),输出是 \(\mathcal{C}(x, y) \in \{0, 1\}^n\). 我们假设 \(\mathcal{C}\) 的每条输出导线不会是其他门的输入导线(如果 \(\mathcal{C}\) 不满足这个条件,在输出前和1做与运算即可)。
对于 \(\mathcal{C}\) 中的每一个门 \(g\),混淆表的构造方式如下。由于 \(g\) 是布尔门,所以它可以表示为函数 \(g: \{0, 1\} \times \{0, 1\} \rightarrow \{0, 1\}\).(注:非门(NOT)只有一个输入,可以通过“和常数1异或”来实现,后面的「混淆电路的优化」一节会讲到:可以将异或门的开销优化为免费的。因为电路中无需设置非门。)设 \(g\) 的输入导线是 \(w_1\) 和 \(w_2\),输出导线是 \(w_3\). \(k_1^0, k_1^1, k_2^0, k_2^1, k_3^0, k_3^1\) 是运行 \(\mathsf{Gen(1^n)}\) 得到的密钥。为了简单起见,我们假设密钥的长度也是 \(n\). 我们希望计算方能够从 \(k_1^\alpha, k_2^\beta\) 计算出 \(k_3^{g(\alpha, \beta)}\),并且不能获得关于 \(k_3^{g(1-\alpha, \beta)}, k_3^{g(\alpha, 1-\beta)}, k_3^{g(1-\alpha, 1-\beta)}\) 的任何信息。因此,门 \(g\) 由以下四个值构成
其中 \(\mathsf{Enc}\) 是对称加密方案 \((\mathsf{Gen}, \mathsf{Enc}, \mathsf{Dec})\) 的加密算法,且该对称加密方案满足选择明文攻击安全(IND-CPA secure)、有不可知的密文空间、可验证的密文空间(见定义 8.1)。最后,我们还需要将这四个值随机排列,令排列后的值为 \(c_0, c_1, c_2, c_3\),我们将其称为门 \(g\) 的混淆表(garbled table)。不难发现,在已知 \(k_1^\alpha, k_2^\beta\) 的情况下很容易计算 \(k_3^{g(\alpha, \beta)}\),计算方式如下:对于每个 \(i \in \{0, 1, 2, 3\}\),计算 \(\mathsf{Dec}_{k_2^\beta}(\mathsf{Dec}_{k_1^\alpha}(c_i))\),如果有多个项解密成功(解密得到的不是 \(\bot\)),输出 \(\mathsf{abort}\),否则,将唯一解密成功得到的值定义为 \(k_3^\gamma\).(如果只有一项解密成功,那么一定有 \(k_3^\gamma = k_3^{g(\alpha, \beta)}\),后面我们将证明:有多个项解密成功的概率是可忽略的。)
完整的混淆电路包含了每个门的混淆表。设电路 \(\mathcal{C}\) 的导线数量为 \(m\),设 \(w_1, …, w_m\) 为这些导线的标签(label)。如果 \(w_i\) 和 \(w_j\) 都来自门 \(g\) 的输出导线,我们将其视为一条导线,即 \(w_i = w_j\);同样地,如果某个输入比特是多个门的输入,我们也将其视为一条导线。对于每个标签 \(w_i\),选取两个独立的密钥 \(k_i^0, k_i^1 \leftarrow \mathsf{Gen}(1^n)\);总共需要选取 \(2m\) 个密钥,它们都是互相独立的。根据这些密钥,我们可以按照上述方式计算每个门的混淆表。最后,对于输出导线,需要计算解密表。如果 \(w_i\) 是一条输出导线,那么它的解密表包括 \((0, k_i^0)\) 和 \((1, k_i^1)\).
我们用 \(G(\mathcal{C})\) 来表示 \(\mathcal{C}\) 的混淆电路,它包括每个门的混淆表和输出的解密表。至此,我们完成了构造混淆电路的形式化描述。
下面,我们证明上述混淆电路的构造方式满足正确性。
姚氏混淆电路协议描述。至此,我们可以给出姚氏混淆电路协议的形式化描述,如图 8.1所示。
安全性分析
首先,让我们直观地分析一下姚氏混淆电路协议的安全性。
正确性。根据引理 8.2,如果加密方案具有不可知的密文空间、可验证的密文空间,那么 \(P_2\) 计算混淆电路得到的是正确的 \(\mathcal{C}(x, y) = f(x, y)\).
隐私性。协议中,\(P_1\) 收到的消息除了最后的输出 \(f(x, y)\),只有OT协议中的消息。根据OT协议的安全性,\(P_1\) 无法知道 \(P_2\) 的输入。对 \(P_2\) 来说,他在协议中收到了混淆电路 \(G(\mathcal{C})\)、\(x\) 对应的密钥 \(k_1^{x_1}, …, k_n^{x_n}\),并执行了OT协议。根据引理 8.1,如果使用了IND-CPA安全的加密方案,它也满足双重加密安全,也就是说,无法成功解密的其他项不会泄露任何关于明文的信息;而 \(x\) 对应的密钥是随机选取的,也不会泄露 \(x\). 直观上看,协议满足隐私性。
如果要将以上的直观分析转化为形式化的证明,模拟器 \(\mathcal{S}\) 应该如何构造呢?我们仍采用模块化的思想,假设存在OT协议 \(\Pi_\mathsf{OT}\) 安全实现了理想功能 \(\mathcal{F}_{\mathsf{OT}}\),然后我们在 \(\mathcal{F}_{\mathsf{OT}}\)-混合模型下进行证明。对于 \(P_1\) 被攻陷的情况,\(P_1\) 在OT协议外收到的消息只有 \(f(x, y)\),且 \(P_1\) 是OT的发送方,在OT协议中没有输出,所以它的视图在 \(\mathcal{F}_{\mathsf{OT}}\)-混合模型下可以完美地模拟。
对于 \(P_2\) 被攻陷的情况,\(\mathcal{S}\) 又应该如何构造呢?此时,模拟器 \(\mathcal{S}\) 需要发送混淆电路 \(G(\mathcal{C})\) 给 \(P_2\). \(\mathcal{S}\) 不知道 \(P_1\) 的输入,因此它不能遵循协议诚实地构造 \(G(\mathcal{C})\),但是 \(\mathcal{S}\) 可以根据协议的输出 \(\mathcal{C}(x, y)\),构造一个“假的”混淆电路,使得 \(P_2\) 无论使用的是哪个密钥,最后的输出总是 \(\mathcal{C}(x, y)\).(这个“假的”混淆电路的构造方式将在后文具体介绍。)然后,\(\mathcal{S}\) 发送密钥 \(k_1^0, …, k_n^0\) 给 \(P_2\),并模拟OT协议使 \(P_2\) 得到 \(k_{n+1}^{y_1}, …, k_{2n}^{y_n}\).
细心的读者可能会发现,这样的模拟方式在通用可组合模型下会出现问题。在通用可组合模型中,环境 \(\mathcal{Z}\) 可以实时地与协议交互,为协议提供输入,并控制消息的发送顺序。但是,当 \(P_1\) 发送混淆电路 \(G(\mathcal{C})\) 时,\(\mathcal{Z}\) 可能还没有给 \(P_2\) 提供输入;换句话说,\(\mathcal{Z}\) 可以让 \(P_1\) 先执行第1步发送混淆电路,然后在第2步执行OT时才给 \(P_2\) 提供输入。对于这样的情况, \(\mathcal{S}\) 就无法构造一个输出总是 \(\mathcal{C}(x, y)\) 的“假的”混淆电路了,因为此时 \(P_2\) 的输入还没有确定。
因此,这个协议不能被证明是通用可组合安全的。我们需要在一个稍微弱一点的模型——独立(stand-alone)模型 [Canetti, 2000; Goldreich, 2004]下进行安全性证明。下面,我们介绍独立模型,并展示它与通用可组合模型的不同之处。
独立模型
直观地说,在通用可组合模型中,环境 \(\mathcal{Z}\) 可以实时地与协议交互,因此模拟器 \(\mathcal{S}\) 也必须根据 \(\mathcal{Z}\) 的行为提供实时的模拟。而在独立(stand-alone)模型中,(对于半诚实敌手)\(\mathcal{S}\) 的输入是被攻陷方的输入和输出,它需要模拟被攻陷方的视图,这里 \(\mathcal{S}\) 提供的是一种更“静态”的模拟,因为协议的输入在一开始就确定了,而不是在协议执行中实时选择的。
我们首先考虑两个参与方、半诚实敌手的情况,给出其在独立模型下的安全定义 [Canetti, 2000; Goldreich, 2004]。
安全定义(半诚实敌手)。我们定义以下符号:
令 \(f = (f_1, f_2)\) 是概率多项式时间功能。令 \(\Pi\) 是计算 \(f\) 的两方协议。
第 \(i\) 个参与方(\(i \in \{1, 2\}\))在双方以 \((x, y)\) 为输入执行协议 \(\Pi\) 时的视图记为 \(\text{view}_{i}^\Pi(x, y)\),它等于 \((x, r^i, m_1^i, …, m_t^i)\),其中 \(r^i\) 是第 \(i\) 个参与方的内部随机数,\(m_j^i\) 是他收到的第 \(j\) 条消息。
第 \(i\) 个参与方(\(i \in \{1, 2\}\))在双方以 \((x, y)\) 为输入执行协议 \(\Pi\) 时的输出记为 \(\text{output}_{i}^\Pi(x, y)\),它可以从第 \(i\) 个参与方的视图中计算得到。记 \(\text{output}^\Pi(x, y) = (\text{output}_{1}^\Pi(x, y), \text{output}_{2}^\Pi(x, y))\).
在本书的定理中,我们用“安全实现”表示独立模型下的安全实现,与“UC-安全实现”加以区分。
注意,如果 \(f\) 是概率功能,那么仅仅要求 \(\mathcal{S}_{i}\) 的输出与 \(view_i^\Pi(x, y)\) 不可区分是不够的,必须考虑它与协议输出的联合分布(我们在「定义隐私性」一节讨论过这一点)。但是,对于确定性功能,可以使用以下简化的定义。
对于确定性功能的简化定义。对于确定性功能,我们无需考虑联合分布,只需要 \(\mathcal{S}_{i}\) 的输出与 \(view_i^\Pi(x, y)\) 不可区分,其定义如下。
单一输出确定性功能。功能 \(f = (f_1, f_2)\) 如果满足 \(f_1 = f_2\),我们称之为单一输出的功能。下面我们说明:单一输出确定性功能可以实现任意的概率功能。
首先,我们说明如何实现概率功能。令 \(f = (f_1, f_2)\) 是一个单一输出概率功能。定义确定性功能 \(f'((x, r), (y, s)) = f(x, y, r \oplus s)\),并假设 \(\Pi'\) 安全实现了 \(f'\). 实现 \(f\) 的协议 \(\Pi\) 构造如下:当收到协议输入 \(x, y \in \{0, 1\}^n\) 时,\(P_1\) 均匀随机选取 \(r \leftarrow_{\$} \{0, 1\}^{q(n)}\),\(P_2\) 均匀随机选取 \(s \leftarrow_{\$} \{0, 1\}^{q(n)}\),其中 \(q(n)\) 是所需随机比特的上限。然后 \(P_1\) 和 \(P_2\) 分别以 \((x, r)\) 和 \((y, s)\) 为输入执行协议 \(\Pi'\),协议结束后,双方就得到了 \(f'((x, r), (y, s)) = f(x, y, r \oplus s)\).
下面,我们展示如何实现双方获得不同输出的情况,即实现功能 \(f = (f_1, f_2)\),其中 \(f_1 \neq f_2\). 我们定义确定性功能 \(f'((x, r), (y, s)) = (f_1(x, y) \oplus r || f_2(x, y) \oplus s)\),并假设 \(\Pi'\) 安全实现了 \(f'\). 实现 \(f\) 的协议 \(\Pi\) 构造如下:当收到协议输入 \(x, y \in \{0, 1\}^n\) 时,\(P_1\) 均匀随机选取 \(r \leftarrow_{\$} \{0, 1\}^{q(n)}\),\(P_2\) 均匀随机选取 \(s \leftarrow_{\$} \{0, 1\}^{q(n)}\),其中 \(q(n)\) 是输出长度的上限。然后 \(P_1\) 和 \(P_2\) 分别以 \((x, r)\) 和 \((y, s)\) 为输入执行协议 \(\Pi'\),协议结束后,双方得到 \(f'((x, r), (y, s)) = (f_1(x, y) \oplus r || f_2(x, y) \oplus s)\). 令 \((v, w) = f'((x, r), (y, s))\). \(P_1\) 计算 \(v \oplus r\) 得到 \(f_1(x, y)\),\(P_2\) 计算 \(w \oplus s\) 得到 \(f_2(x, y)\).
综上所述,单一输出确定性功能可以实现任意的概率功能。因此,虽然「协议描述」一节的姚氏混淆电路协议只考虑了单一输出确定性功能,但我们可以基于它实现任意的概率功能。
并发组合的(不)安全性。我们前面讲到,与通用可组合模型相比,独立模型提供了弱一些的安全保证。具体而言,在独立模型中被证明安全的协议,当与其他协议并发运行时,可能是不安全的。我们通过一个例子来展示这一点 [Canetti, 2006]。
考虑密钥交换(key exchange)的场景。\(P_1\) 和 \(P_2\) 希望生成一个共同的密钥,这个密钥对于可以观察网络通信的敌手是未知的。在实际场景中,生成的密钥往往会用于消息的加密或认证。假设 \(\Pi\) 是在独立模型下被证明安全的密钥交换协议。定义协议 \(\Pi'\) 如下:\(\Pi'\) 与 \(\Pi\) 相同,但增加了以下指令:“如果密钥已经生成,接收一条消息,如果这条消息等于生成的密钥,回复yes,否则回复no。”
首先,我们论证 \(\Pi'\) 在独立模型下仍然是安全的。因为 \(\Pi\) 是一个安全的协议,所以敌手不可能从参与方发送的消息中得到密钥的信息。因此,敌手猜对密钥的概率是可忽略的,双方最后几乎总是回复no,因而协议 \(\Pi'\) 与协议 \(\Pi\) 的效果相同(排除可忽略的猜对密钥的概率)。
下面,让我们看一下 \(\Pi'\) 与加密方案组合使用时的情况。假设参与方使用的是“一次一密”,即给定消息 \(m\) 和密钥 \(k\),输出密文 \(c = k \oplus m\). 这是一个完美安全的加密方案。假设加密的消息只可能是``buy''或``sell''. 也就是说,\(P_1\) 和 \(P_2\) 首先运行协议 \(\Pi'\) 生成密钥 \(k\),然后 \(P_1\) 发送密文 \(c\) 给 \(P_2\),\(c\) 只可能是 \(k \oplus \text{``buy''}\) 或 \(k \oplus \text{``sell''}\).
此时,敌手就可以利用 \(\Pi'\) 中增加的指令进行攻击。敌手观察到密文 \(c\),然后计算 \(c' = c \oplus \text{``buy''}\) 并发送给 \(P_1\). 此时,如果加密的是``buy'',那么 \(c' = c \oplus \text{``buy''} = k \oplus \text{``buy''} \oplus \text{``buy''} = k\),\(P_1\) 会回复yes;如果加密的是``sell'',\(P_1\) 则会回复no. 这意味着在协议 \(\Pi'\) 与“一次一密”并发组合的情况下,敌手可以知道加密的消息!
这个例子说明了:当两个协议 \(\Pi_1\) 和 \(\Pi_2\) 并发执行且 \(\Pi_2\) 使用了 \(\Pi_1\) 的输出时,敌手可能会利用与 \(\Pi_1\) 的交互来获取额外的信息,从而攻击 \(\Pi_2\). 独立模型只考虑了协议单独运行的情况,因此没有涵盖这种攻击方式。
我们之前说过,通用可组合模型下被证明安全的协议可以任意地与其他协议组合。那么协议 \(\Pi'\) 当然不应该在通用可组合模型下被证明安全。事实也确实如此。在通用可组合模型中,环境 \(\mathcal{Z}\) 可以实时地与协议交互,\(\mathcal{Z}\) 首先让 \(P_1\) 和 \(P_2\) 运行协议生成密钥(\(P_1\) 和 \(P_2\) 都是诚实方),\(\mathcal{Z}\) 获得诚实方的输出,即密钥 \(k\),然后 \(\mathcal{Z}\) 让敌手 \(\mathcal{A}\) 发送消息 \(k'\) 给 \(P_1\),\(k'\) 有1/2概率等于 \(k\),有1/2概率为随机密钥。如果在真实世界,当 \(k' = k\) 时 \(P_1\) 会回复yes,当 \(k'\) 为随机密钥时(以压倒性的概率)回复no;如果在理想世界,\(P_1\) 是模拟器 \(\mathcal{S}\) 模拟的,它不可能知道理想功能生成的密钥 \(k\),因此 \(\mathcal{S}\) 不知道应该回复yes还是no,它有1/2的概率模拟失败。从这个例子可以看出,环境 \(\mathcal{Z}\) 与协议的实时交互准确地体现了并发组合时协议可能面对的任何外部环境。
顺序组合的安全性。幸运的是,独立模型虽然不能保证并发组合的安全性,但也提供了不错的安全性保证——独立模型下证明安全的协议在顺序组合时仍然是安全的。具体而言,令 \(p(n)\) 是一个多项式,\(\rho_1, …, \rho_{p(n)}\) 是一系列协议,其中 \(\rho_i\) 安全实现了理想功能 \(f_i\). 如果协议 \(\Pi\) 在 \(f_1, …, f_{p(n)}\)-混合模型下安全实现了理想功能 \(g\),那么 \(\Pi^{\rho_1, …, \rho_{p(n)}}\) 安全实现了理想功能 \(g\),\(\Pi^{\rho_1, …, \rho_{p(n)}}\) 表示将协议中对 \(f_j\) 的请求替换为执行子协议 \(\rho_j\),且这些子协议顺序执行。
该定理的证明思路与定理 4.3非常类似,区别在于这里我们限制了敌手的能力,敌手不能实时地与协议交互,且子协议必须顺序执行。本书不再给出该定理的形式化证明,感兴趣的读者可以参阅书 [Goldreich, 2004],Sections 7.3.1和7.4.1. 不过,我们可以以上面的密钥交换协议为例,直观地展示协议 \(\Pi'\) 在顺序组合下是安全的。当协议 \(\Pi'\) 与“一次一密”顺序组合时,参与方先执行完成协议 \(\Pi'\),再使用“一次一密”进行加密。那么,当敌手观察到密文 \(c\) 时,密钥交换协议 \(\Pi'\) 已经运行结束了,敌手无法利用 \(\Pi'\) 获取明文信息,因而上述攻击方式在顺序组合时就不存在了。
对于恶意敌手的安全性定义。与通用可组合模型类似,独立模型下的安全性定义很容易拓展到恶意敌手的情形。在恶意敌手模型下,敌手可以任意地违背协议,其造成的影响始终等价于“输入替换”。但是,独立模型下敌手不能实时地与协议交互,也就是说,敌手必须在协议一开始就确定诚实方的输入,以及被攻陷方攻击协议的方式。形式化地说,对于每个被攻陷方 \(P_i\),敌手需要在协议开始前确定它运行的算法 \(A_i\). 安全性定义要求:存在一个模拟器,它能够模拟被攻陷方的视图,并提取被攻陷方的输入,使得协议输出与理想功能的输出相一致。
下面,我们给出形式化的定义。仍然考虑两个参与方的情况。设功能 \(f = (f_1, f_2)\). 第一个参与方 \(P_1\) 的输入是 \(x\),第二个参与方 \(P_2\) 的输入是 \(y\). 他们希望计算功能 \(f\) 使 \(P_1\) 得到 \(f_1(x, y)\),\(P_2\) 得到 \(f_2(x, y)\). 由于敌手可以任意地违背协议,有些影响是协议无法避免的:(1) 敌手可以替换自己的输入;(2) 敌手可以不参与协议;(3) 敌手可以执行过程中提前结束协议。也就是说,在恶意敌手模型下协议无法实现公平性(fairness) [Cleve, 1986],协议有可能让恶意的参与方获得输出,但诚实的参与方没有获得输出。因此,理想世界的运行过程如下。
输入:每个参与方获得一个输入,记为 \(w\)(对 \(P_1\) 而言 \(w = x\),对 \(P_2\) 而言 \(w = y\))。
向可信方(trusted party)发送输入:诚实的参与方总是将 \(w\) 发给可信方。恶意的参与方可以根据 \(w\) 选择结束协议或发送 \(w' \in \{0, 1\}^{|w|}\) 给可信方。
可信方回复第一个参与方。当可信方收到输入对 \((x, y)\) 后,他首先向第一个参与方发送 \(f_1(x, y)\). 如果可信方只收到一个合法的输入,他向两个参与方都发送 \(\bot\).
可信方回复第二个参与方。如果第一个参与方是恶意的,他可以基于自己的输入和可信方的回复,决定是否让可信方终止。如果第一个参与方选择终止,可信方向第二个参与方发送 \(\bot\) 并终止;否则,可信方向第二个参与方发送 \(f_2(x, y)\).
输出:诚实的参与方总是将他从可信方收到的消息作为输出。恶意的参与方可以输出一个关于他的输入和来自可信方消息的(概率多项式时间可计算的)函数。
令 \(f: \{0, 1\}^* \times \{0, 1\}^* \rightarrow \{0, 1\}^* \times \{0, 1\}^*\) 是一个功能,其中 \(f = (f_1, f_2)\). 令 \(\overline{M} = (M_1, M_2)\) 是一对非统一的(non-uniform)(注:非统一(non-uniform)指的是一个算法无需支持任意的输入,而是可以对每个输入定义单独的算法。例如,如果一个RSA加密算法只支持2048位的密钥就是非统一的,如果支持任意长度的密钥就是统一的。因此,非统一的算法相较于统一的算法,实际上放宽了限制。)概率期望多项式时间(probabilistic expected polynomial-time)(注:一个概率期望多项式时间算法,它的运行时间的期望是多项式的,但不保证对每一个输入的运行时间都是多项式的。)的机器(代表理想世界中的参与方)。如果存在至少一个 \(i \in \{1, 2\}\) 满足 \(M_i\) 是诚实的(即遵循上述理想世界中诚实方的指令),那么我们说 \(\overline{M}\) 是可允许的(admissible)。我们将\(\overline{M}\) 在理想世界中对 \(f\) 的执行(以 \((x, y)\) 为输入)记为 \(\operatorname{ideal}_{f, \overline{M}}(x, y)\),它被定义为上述理想世界运行中 \(M_1\) 和 \(M_2\) 的输出。
真实世界的运行过程如下。令 \(f: \{0, 1\}^* \times \{0, 1\}^* \rightarrow \{0, 1\}^* \times \{0, 1\}^*\) 是一个功能,其中 \(f = (f_1, f_2)\). 令 \(\Pi\) 是一个计算 \(f\) 的两方协议。令 \(\overline{M} = (M_1, M_2)\) 是一对非统一的概率多项式时间的机器(代表真实世界中的参与方)。如果存在至少一个 \(i \in \{1, 2\}\) 满足 \(M_i\) 是诚实的(即遵循协议 \(\Pi\) 中的指令),那么我们说 \(\overline{M}\) 是可允许的。我们将\(\overline{M}\) 在真实世界中对 \(\Pi\) 的执行(以 \((x, y)\) 为输入)记为 \(\operatorname{real}_{\Pi, \overline{M}}(x, y)\),它被定义为真实世界运行中 \(M_1\) 和 \(M_2\) 的输出。
安全性基于真实世界模拟了理想世界,即,对于每一对真实世界中可允许的机器,存在一对理想世界中可允许的机器,使得两个世界的执行是不可区分的。
我们对上述定义稍作分析。不妨假设 \(A_2, B_2\) 是诚实的。要使得定义中的约等于号成立,首先我们要保证诚实方(\(A_2\) 与 \(B_2\))的输出在两个世界中是一样的。在理想世界,\(B_2\) 的输出来自可信方;在真实世界,\(A_2\) 的输出是执行协议得到的。两者相等意味着理想世界中的被攻陷方 \(B_1\) 必须提取正确的输入发送给可信方。
另一方面,我们还需要让被攻陷方(\(A_1\) 与 \(B_1\))的输出有不可区分的分布。在真实世界,\(A_1\) 在协议结束后可以输入任何它想输出的东西;在理想世界,\(B_1\) 最好的策略只能是把 \(A_1\) 输出的东西原封不动地输出。两者有不可区分的分布本质上意味着 \(A_1\) 不能区分理想世界和真实世界。
注意,\(B_1\) 是基于 \(A_1\) 的,所以 \(B_1\) 可以在内部运行 \(A_1\),模拟 \(A_1\) 的视图,并从 \(A_1\) 发送的消息中提取协议输入,从而完成上述模拟。
从上述分析来看,独立模型的思想和通用可组合模型非常类似,机器 \(B_1\) 实际上扮演了模拟器 \(\mathcal{S}\) 的角色。区别在于:\(A_1\) 的程序在协议运行前就已经确定了,而不能够在协议运行中与环境 \(\mathcal{Z}\) 实时通信,根据 \(\mathcal{Z}\) 接收到的消息来调整攻击方式。
独立模型与通用可组合模型的关系。总结上述分析可以看出,独立模型与通用可组合模型最主要的不同在于:通用可组合模型中,环境 \(\mathcal{Z}\) 可以与协议实时地交互,它模拟了协议可能面对的任何外部环境;而独立模型没有定义环境 \(\mathcal{Z}\),其考虑的是协议单独运行的安全性。这样的设定导致的一个技术上的区别在于:在通用可组合模型中,模拟器 \(\mathcal{S}\) 不可以将环境 \(\mathcal{Z}\) “倒带”(rewind);而在独立模型中,对于恶意敌手时,“倒带”是模拟器 \(\mathcal{S}\) 提取敌手(被攻陷方)输入的一种常用技术。具体而言,“倒带”指的是当协议运行到某一步骤时,\(\mathcal{S}\) 在此处为敌手设置一个断点,然后继续运行协议。之后,\(\mathcal{S}\) 可以使敌手的程序回到断点处,然后与敌手再次运行协议(但是这次会发送不同的消息),从而提取敌手的输入。
现在,我们对环境 \(\mathcal{Z}\) 施加一些限制,定义一个弱一些的环境。这个弱一些的环境只能与协议交互两次:第一次在协议开始前,\(\mathcal{Z}\) 为诚实方提供输入,并决定敌手 \(\mathcal{A}\) 攻击协议的方式;第二次在协议结束后,\(\mathcal{Z}\) 接收诚实方的输出以及 \(\mathcal{A}\) 的消息,并输出一个比特 \(b\). 我们称这样的环境为非并发(non-concurrent)环境。
可以证明,协议 \(\Pi\) 对于非并发环境安全实现了理想功能 \(f\),当且仅当协议 \(\Pi\) 在独立模型下安全实现了 \(f\). 其原理不难理解:在独立模型中,敌手必须在协议开始前决定诚实方的输入和被攻陷方执行的算法,这就等价于限制环境 \(\mathcal{Z}\) 只能在协议开始时和协议结束时交互两次。完整的证明参见文献 [Canetti, 2001; Canetti, 2000](eprint version, Section 7.4)。
安全性证明
现在,我们给出姚氏混淆电路协议在独立模型下的安全性证明。
上一节(「独立模型」一节)讲过,基于单一输出确定性功能可以实现任意的概率功能。我们有以下推论。
混淆电路的优化
在运行姚氏混淆电路协议时,生成混淆电路和计算混淆电路是主要的计算开销,而传输混淆电路是主要的通讯开销。为了提升性能,研究人员提出了多种混淆电路的优化方案。
标识置换(point-and-permute)。在经典方案中,计算方(\(P_2\))在计算混淆电路时,并不知道需要对混淆表的哪一行进行解密,因此只能对每一行都进行解密尝试,对于每个混淆表,平均需要 \(2.5\) 次尝试才能够成功解密。 标识置换方案 [Bea et al., 1990]为每一个密钥附加了一个标识比特。具体而言,对于导线 \(w_a\),它的密钥 \(k_a^0\) 附带了标识比特 \(p_a^0\),密钥 \(k_a^1\) 附带了标识比特 \(p_a^1\),并且导线值\(0\)对应的标识比特和导线值\(1\)对应的标识比特不同,即 \(p_a^0 = 1 - p_a^1\). 我们将 \(k_a^0 || p_a^0\) 称为导线 \(w_a\) 的值\(0\)对应的标签。
标识比特指示了应该解密混淆表的哪一行,从而使得计算方无需逐行尝试。对于输入导线为 \(w_a, w_b\),输出导线为 \(w_c\) 的布尔门,当计算方持有一对标签 \((k_a^\alpha || p_a^\alpha, k_b^\beta || p_b^\beta)\) 时,\(p_a^\alpha || p_b^\beta\) 指示了应当解密的行——如果混淆表的行序号从1开始计数(即混淆表有第1,第2,第3,第4行),那么计算方直接解密第 \(2 p_a^\alpha + p_b^\beta + 1\) 行即可。加入标识比特后,混淆表的生成方式也需要做对应的修改:首先,混淆电路生成方为每条导线随机选择密钥和标识比特,满足每条导线值\(0\)对应的标识比特和值\(1\)对应的标识比特不同。混淆表的各行加密的不仅仅是密钥,而是密钥和标识比特(即标签),例如,与门的某一行应当是 \(\mathsf{Enc}_{k_a^0}(\mathsf{Enc}_{k_b^0}(k_c^0 || p_c^0))\). 其次,混淆表的各行也不再是随机排列,而是根据标识比特,对于标签 \((k_a^\alpha || p_a^\alpha, k_b^\beta || p_b^\beta)\),将其对应的密文放在第 \(2 p_a^\alpha + p_b^\beta + 1\) 行。表 8.5展示了当 \(p_a^0 = 1, \; p_b^0 = 0\) 时,标识置换方案下与门的混淆表,注意最右边一列的混淆表已经根据标识比特进行排列。使用标识置换技术后,加密方案也无需在明文后添加 \(n\) 个0以保证不可知的密文空间了。
| \(k_a^0 || (p_a^0=1)\) | \(k_b^1 || (p_b^1=1)\) | \(\mathsf{Enc}_{k_a^1}( \mathsf{Enc}_{k_b^1}(k_c^1 || p_c^1) )\) |
| \(k_a^1 || (p_a^1=0)\) | \(k_b^0 || (p_b^0=0)\) | \(\mathsf{Enc}_{k_a^0}( \mathsf{Enc}_{k_b^0}(k_c^0 || p_c^0) )\) |
| \(k_a^1 || (p_a^1=0)\) | \(k_b^1 || (p_b^1=1)\) | \(\mathsf{Enc}_{k_a^0}( \mathsf{Enc}_{k_b^1}(k_c^0 || p_c^0) )\) |
标识置换方案,与门的混淆表
混淆表行缩减(Garbled Row Reduction, GRR)。混淆表行缩减最早由Naor,Pinkas和Sumner以\(4\rightarrow 3\)混淆表行缩减(缩写为GRR3)的形式提出 [Naor et al., 1999]。它的思想是:由于混淆表加密的标签是随机数,我们可以通过巧妙地选择这些随机数,使得混淆表的第一行固定为全0字符串。 例如,对于索引为 \(i\) 的门 \(g_i\),假设其输入导线为 \(w_a, w_b\),输出导线为 \(w_c\). 它混淆表的双重加密 \(\mathsf{Enc}_{k_a^\alpha, k_b^\beta}^i(k_c^{g_i(\alpha, \beta)} || p_c^{g_i(\alpha, \beta)})\) 可以实现为 \(H(k_a^\alpha || k_b^\beta || i) \oplus ( k_c^{g_i(\alpha, \beta)} || p_c^{g_i(\alpha, \beta)} )\),其中 \(H\) 是可以理想化为随机谕示机的哈希函数(参见「哈希函数与随机谕示机」一节的定义)。当我们根据标识置换技术对混淆表进行排列后,假设 \(H(k_a^\alpha || k_b^\beta || i) \oplus ( k_c^{g_i(\alpha, \beta)} || p_c^{g_i(\alpha, \beta)} )\) 是混淆表的第一行,那么,由于 \(k_c^{g_i(\alpha, \beta)} || p_c^{g_i(\alpha, \beta)}\) 也是随机选择的,我们只需将其选择为 \(k_c^{g_i(\alpha, \beta)} || p_c^{g_i(\alpha, \beta)} = H(k_a^\alpha || k_b^\beta || i)\),即可使混淆表的第一行为全0字符串,从而对于每个混淆表,只需传输3条密文。
\(4\rightarrow 2\)混淆表行缩减(缩写为GRR2) [PSSW, 2009]通过多项式插值的方式来生成混淆表,生成的混淆表只需要2行。GRR2首先根据布尔门真值表的输出值中0和1的个数,将布尔门分为“奇门”和“偶门”,例如,与门、或门的真值表输出值中0和1的个数是1个或3个,因此它们是“奇门”;异或门的真值表输出值中0和1的个数都是2个,因此它是“偶门”。对于奇门和偶门,需要采用不同的方式构造混淆表。
我们首先定义一些符号。假设门 \(g_i\) 的混淆表的加密方式为 \(\mathsf{Enc}_{k_a^\alpha, k_b^\beta}^i(k_c^{g_i(\alpha, \beta)} || p_c^{g_i(\alpha, \beta)}) = H(k_a^\alpha || k_b^\beta || i) \oplus ( k_c^{g_i(\alpha, \beta)} || p_c^{g_i(\alpha, \beta)} )\),假设密钥的长度为 \(\kappa\) 比特。定义 \(r = 2 p_a^\alpha + p_b^\beta + 1\) 为要解密的行的索引。定义 \(K_r || M_r\) 如下
其中 \(K_r\) 长度为 \(\kappa\) 比特,\(M_r\) 长度为1比特。也就是说,对于密文 \(\mathsf{Enc}^i_{k_a^\alpha, k_b^\beta}(k_c^{g_i(\alpha, \beta)} || p_c^{g_i(\alpha, \beta)})\),我们将 \(H(k_a^\alpha || k_b^\beta || i)\) 视为加密密钥和标识比特的掩码(mask),其中 \(K_r\) 是用于加密密钥的掩码,\(M_r\) 是用于加密标识比特的掩码。
我们以与门为例,展示奇门的混淆表的构造。设布尔门 \(g_i\) 是与门,其输入导线为 \(w_a, w_b\),输出导线为 \(w_c\). 假设它的标识比特为 \(p_a^0 = 0, \; p_b^0 = 0\),那么,此时排列后的混淆表如下
其中,\(K_r || M_r\) 按照式 (式 8.5)所定义。
观察混淆表,发现其1~3行对应的输出密钥都是 \(k_c^0\). 因此对 \((1, K_1), (2, K_2), (3, K_3)\) 这三个点进行插值,得到二次多项式 \(P(X)\). 然后计算 \(K_5 = P(5), K_6 = P(6)\). 再对 \((4, K_4), (5, K_5), (6, K_6)\) 这三个点进行插值,得到二次多项式 \(Q(X)\). 最后,选取密钥 \(k_c^0 = P(0), k_c^1 = Q(0)\),将混淆表设置为 \((K_5, K_6)\) 以及加密的4个标识比特 \((c_1, c_2, c_3, c_4) = (M_1 \oplus p_c^0, M_2 \oplus p_c^0, M_3 \oplus p_c^0, M_4 \oplus p_c^1)\). 也就是说,混淆表的总大小为 \(2 \kappa + 4\) 比特。
当计算方对混淆表进行计算时,他持有 \((k_a^\alpha || p_a^\alpha, k_b^\beta || p_b^\beta)\). 首先,计算 \(r = 2 p_a^\alpha + p_b^\beta + 1\) 和 \(K_r || M_r = H(k_a^\alpha || k_b^\beta || i)\). 然后,他对 \((r, K_r), (5, K_5), (6, K_6)\) 这三个点进行插值。不难发现,如果 \(r = 1, 2, 3\),那么得到的多项式就是 \(P(X)\);如果 \(r = 4\),那么得到的多项式就是 \(Q(X)\). 因此,计算方设置输出密钥 \(k_c^{g_i(\alpha, \beta)}\) 为这个多项式在0处的值,并计算标识比特 \(p_c^{g_i(\alpha, \beta)} = c_r \oplus M_r\). 计算方至此完成该混淆表的计算。不难发现,这样计算的结果是正确的。图 8.2是上述方案的示意图。如果标识比特不是 \(p_a^0 = 0, \; p_b^0 = 0\),只需在构造混淆表时做对应的排列(例如,表 8.5展示的 \(p_a^0 = 1, \; p_b^0 = 0\) 的情况,只需分别对 \((1, K_1), (3, K_3), (4, K_4)\) 和 \((2, K_2), (5, K_5), (6, K_6)\) 进行插值即可)。
混淆电路的优化 · 插图
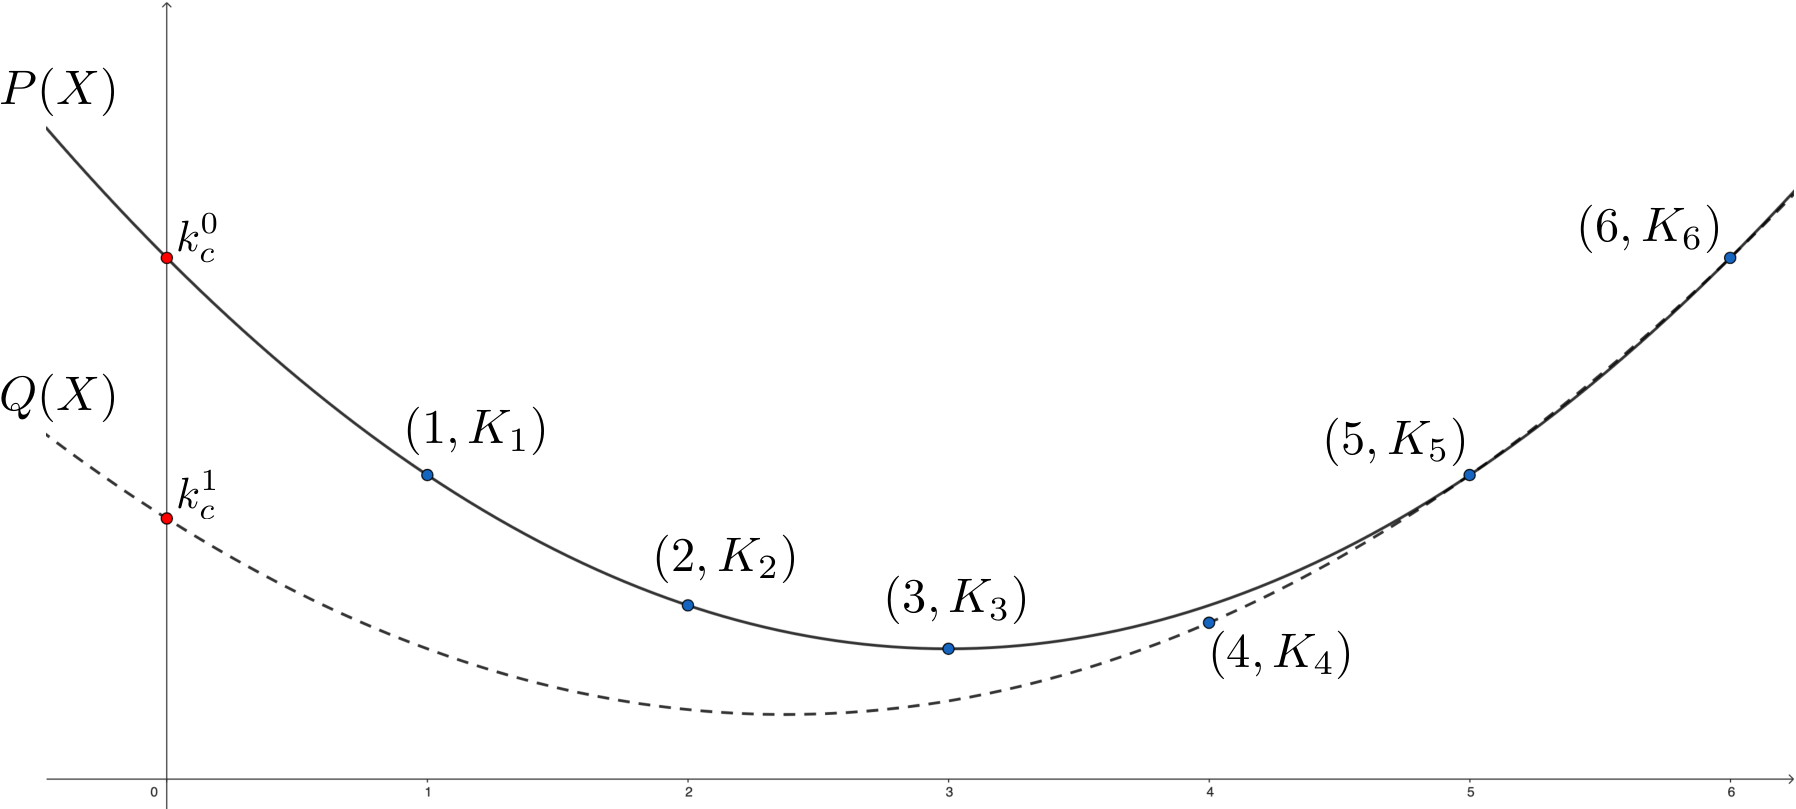
GRR2示意图(奇门)
其中,\(K_r || M_r\) 按照式 (式 8.5)所定义。
观察混淆表,发现第1、第4行对应的输出密钥是 \(k_c^0\),第2、第3行对应的输出密钥是 \(k_c^1\). 因此对 \((1, K_1), (4, K_4)\) 进行插值得到 \(P(X)\),选取密钥 \(k_c^0 = P(0)\),如果 \(k_c^0\) 对应的标识比特 \(p_c^0 = 0\),就把 \(P(5)\) 放在混淆表的第1行,否则放在第2行;类似地,对 \((2, K_2), (3, K_3)\) 进行插值得到 \(Q(X)\),选取密钥 \(k_c^1 = Q(0)\),然后把 \(Q(5)\) 放在混淆表的另一行。混淆表被设置为两个长度为 \(\kappa\) 比特的值以及加密的4个标识比特 \((c_1, c_2, c_3, c_4) = (M_1 \oplus p_c^0, M_2 \oplus p_c^1, M_3 \oplus p_c^1, M_4 \oplus p_c^0)\),混淆表的总大小仍为 \(2 \kappa + 4\) 比特。
当计算方对混淆表进行计算时,他持有 \((k_a^\alpha || p_a^\alpha, k_b^\beta || p_b^\beta)\). 首先,计算 \(r = 2 p_a^\alpha + p_b^\beta + 1\) 和 \(K_r || M_r = H(k_a^\alpha || k_b^\beta || i)\). 然后,计算 \(p_c^{g_i(\alpha, \beta)} = c_r \oplus M_r\). 如果该值为0,则取混淆表第1行的值;如果该值为1,则取混淆表第2行的值。记所取的值为 \(K_5\). 最后,计算方对 \((r, K_r), (5, K_5)\) 进行插值。不难发现,如果 \(r = 1, 4\),那么得到的多项式就是 \(P(X)\);如果 \(r = 2, 3\),那么得到的多项式就是 \(Q(X)\). 计算方设置 \(k_c^{g_i(\alpha, \beta)}\) 为这个多项式在0处的值,完成该混淆表的计算。图 8.3是上述方案的示意图。同样地,如果标识比特不是 \(p_a^0 = 0, \; p_b^0 = 0\),只需在构造混淆表时做对应的排列即可。
混淆电路的优化 · 插图
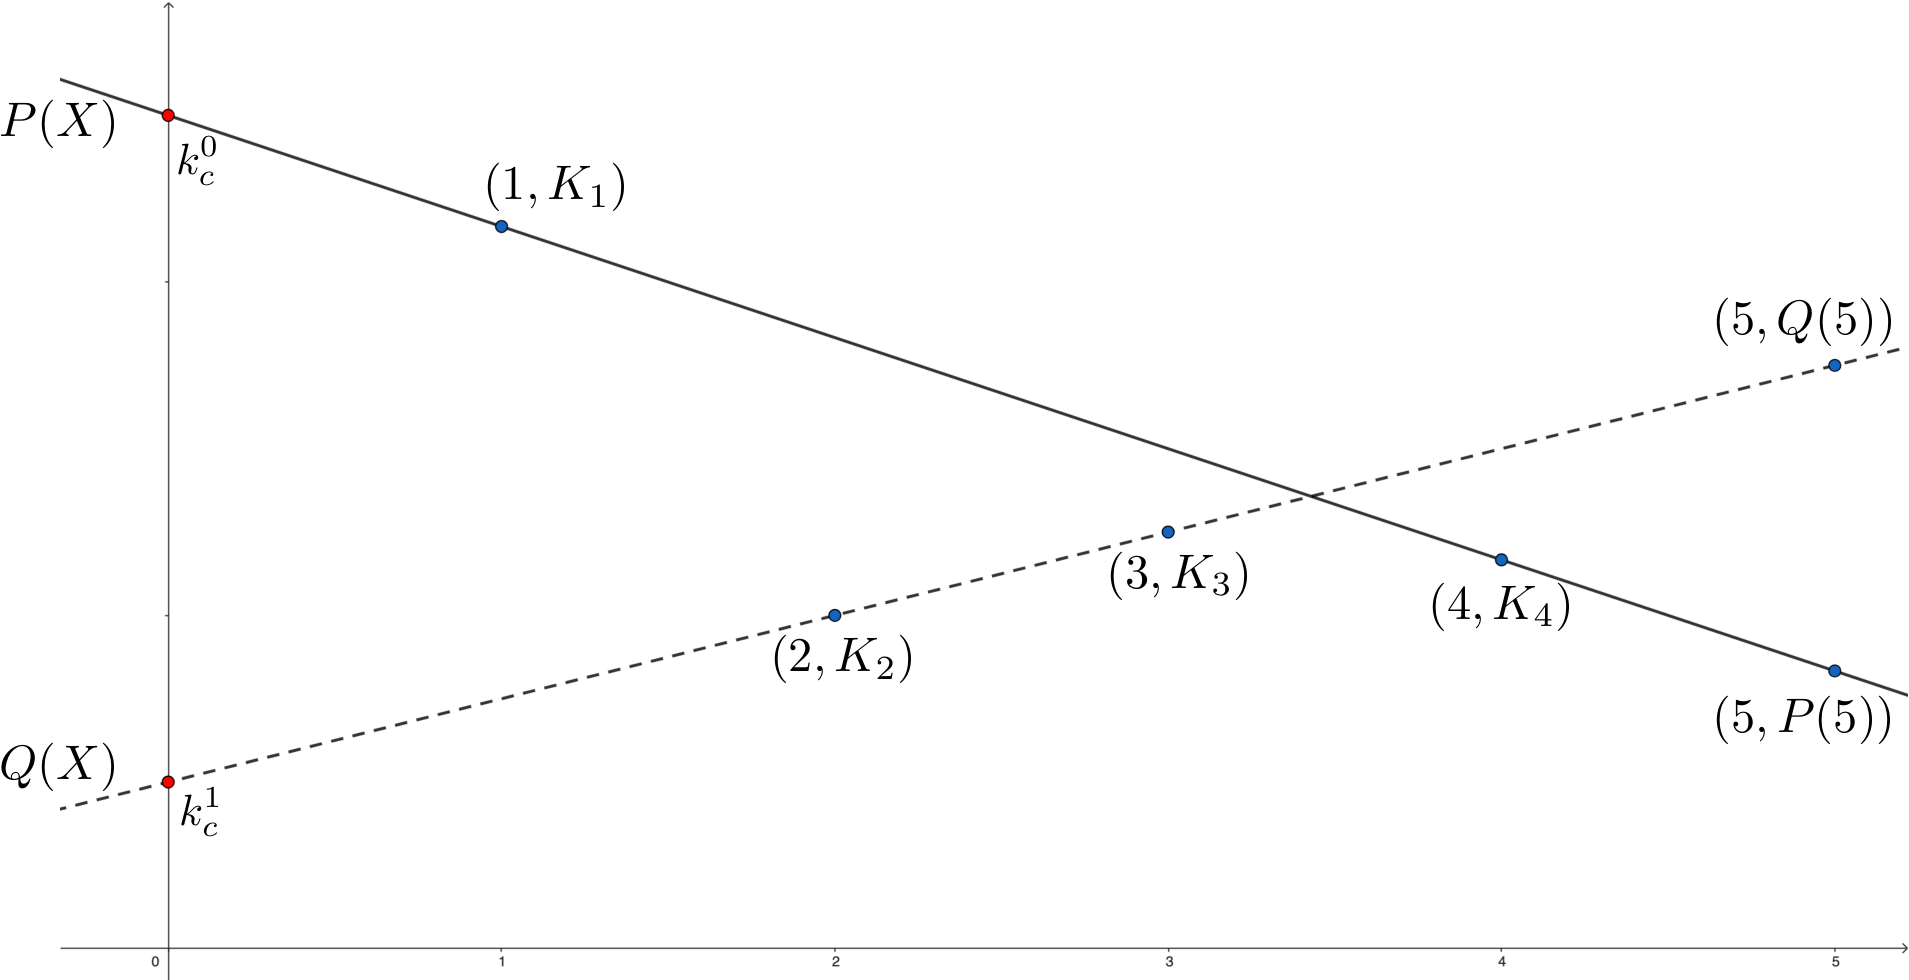
GRR2示意图(偶门)
free-XOR. 顾名思义,free-XOR技术 [Kol & Sch, 2008]可以将异或门的开销变为免费的。在刚才GRR2方案中,我们发现,异或门和其他门有所不同:异或门是偶门,与门、或门都是奇门。而且,\(a \oplus (b \oplus 1) = (a \oplus b) \oplus 1\),也就是将异或门的一个输入翻转,会导致异或门的输出也翻转。异或门的这个性质使研究者思考:当异或门的输入标签是 \((k_a^\alpha || p_a^\alpha, k_b^\beta || p_b^\beta)\) 时,能否使输出标签 \(k_c^{g(\alpha, \beta)} || p_c^{g(\alpha, \beta)}\) 就等于 \((k_a^\alpha || p_a^\alpha) \oplus (k_b^\beta || p_b^\beta)\)呢?如果这可以实现,异或门的计算就无需任何解密操作了。
为此,混淆电路生成方在生成混淆电路时首先随机选取一个全局偏移量 \(\Delta \leftarrow_{\$} \{0,1\}^{\kappa}\). 对于每条导线的标签,算法强制要求对应于 \(0\) 的密钥和对应于 \(1\) 的密钥的异或结果等于全局偏移量,即任意导线 \(w_a\) 都满足 \(k_a^0 \oplus k_a^1 = \Delta\). 当生成方随机选择了 \(0\)、\(1\) 密钥中的一个,就同时确定了另一个。对于异或门 \(g\),假设其输入导线为 \(w_a, w_b\),输出导线为 \(w_c\),其输出密钥设置为 \(k_c^0 = k_a^0 \oplus k_b^0, \; k_c^1 = k_a^0 \oplus k_b^0 \oplus \Delta\),输出导线的标识比特设置为 \(p_c^0 = p_a^0 \oplus p_b^0, \; p_c^1 = p_a^0 \oplus p_b^0 \oplus 1\). 这样,计算方在计算异或门时,可以通过计算 \(k_c^{g(\alpha, \beta)} || p_c^{g(\alpha, \beta)} = (k_a^\alpha || p_a^\alpha) \oplus (k_b^\beta || p_b^\beta)\) 直接得到输出标签。
需要注意的是,标识置换技术、GRR3和free-XOR是相互兼容的。free-XOR选取了全局偏移量 \(\Delta\),将异或门的开销变为免费的,这并不影响与门、或门仍使用GRR3进行优化。GRR3需要将一个密钥设置为哈希的输出,这与全局偏移量 \(\Delta\) 并不冲突。当同时使用标识置换技术、GRR3和free-XOR时,混淆电路的构造方式如下:
随机选取全局偏移量 \(\Delta \leftarrow_{\$} \{0,1\}^{\kappa}\).
对于电路的每条输入导线 \(w_i\),随机选择0对应的导线标签 \(k_i^0 || p_i^0 \leftarrow_{\$} \{0, 1\}^{\kappa+1}\). 设置1对应的导线标签为 \(k_i^1 || p_i^1 = (k_i^0 \oplus \Delta) || (p_i^0 \oplus 1)\).
按照拓扑顺序对电路中的每个门 \(g_i\) 按照如下方式构造混淆表(假设 \(g_i\) 的输入导线为 \(w_a, w_b\),输出导线为 \(w_c\),输入标签为 \((k_a^0 || p_a^0, k_a^1 || p_a^1), (k_b^0 || p_b^0, k_b^1 || p_b^1)\)):
如果 \(g_i\) 是异或门,设置输出密钥为 \(k_c^0 = k_a^0 \oplus k_b^0, \; k_c^1 = k_a^0 \oplus k_b^0 \oplus \Delta\),设置输出导线的标识比特为 \(p_c^0 = p_a^0 \oplus p_b^0, \; p_c^1 = p_a^0 \oplus p_b^0 \oplus 1\).
如果 \(g_i\) 不是异或门,按照标识比特排列其混淆表。假设第一行为 \(H(k_a^\alpha || k_b^\beta || i) \oplus ( k_c^{g_i(\alpha, \beta)} || p_c^{g_i(\alpha, \beta)} )\),设置 \(( k_c^{g_i(\alpha, \beta)} || p_c^{g_i(\alpha, \beta)} ) = H(k_a^\alpha || k_b^\beta || i)\),设置 \(k_c^{1-g_i(\alpha, \beta)} = k_c^{g_i(\alpha, \beta)} \oplus \Delta, \; p_c^{1-g_i(\alpha, \beta)} = p_c^{g_i(\alpha, \beta)} \oplus 1\).
最后,对于电路的每条输出导线,生成解密表。导线 \(w_i\) 的解密表包含 \((0, H(k_i^0))\) 和 \((1, H(k_i^1))\),其中 \(H\) 是随机谕示机。这是为了防止解密表泄漏全局偏移量 \(\Delta\).
但是,GRR2和free-XOR不兼容。因为GRR2中的密钥是插值多项式在0处的值,这是一个随机值,所以无法使电路中的所有密钥对都有相同的全局偏移量 \(\Delta\). 因此,同时使用标识置换技术、GRR3和free-XOR一种很好的优化方案。不过,需要注意的是,由于free-XOR技术要求密钥对都有相同的全局偏移值,这使得底层的加密方案需要假设 \(H\) 是随机谕示机(注:更准确地说,\(H\) 只需要满足关联健壮性(correlation robustness),读者可参阅文献 [Kol & Sch, 2008]。),而无法基于伪随机函数构造(注:这是因为,如果使用的密钥有相同的偏移值,那么伪随机函数的定义无法保证加密方案的隐私性。)。GRR2不需要假设 \(H\) 是随机谕示机(或满足关联健壮性)(注:具体而言,对于索引为 \(i\) 的门 \(g_i\),如果 \(H\) 是随机谕示机,\(\mathsf{Enc}_{k_1, k_2}^i(m)\) 可以实现为 \(H(k_1 || k_2 || i) \oplus m\);如果 \(H\) 是伪随机函数,\(\mathsf{Enc}_{k_1, k_2}^i(m)\) 可以实现为 \(H(k_1 || i) \oplus H(k_2 || i) \oplus m\),这里 \(H(k || i)\) 表示伪随机函数 \(H\) 以 \(k\) 为密钥,\(i\) 为输入时的输出。当密钥都是随机选取的时候,这两种构造都是安全的。但是当密钥有关联性时(存在一个全局偏离值),必须假设 \(H\) 是随机谕示机(或满足关联健壮性)。)。如果使用者不希望做出过强的假设,或是电路中异或门的比例很小,那么GRR2也是一种很好的优化方案。
半门(half-gates)。上面介绍的优化方案中,GRR2可以将混淆表缩减为2条密文,但与free-XOR不兼容;GRR3与free-XOR兼容,但是只能将混淆表缩减为3条密文。也就是说,上述方案无法同时实现免费的异或门并且将混淆表缩减为2条密文。半门 [Zah et al., 2015]是一种巧妙的优化方案,它可以使奇门(包括与门、或门、与非门、或非门)的混淆表缩减为2条,且与free-XOR完全兼容。
我们先以与门为例展示半门方案的构造。半门的思想是将与门表示为两个半门异或的结果。每个半门都是一个与门,但是有一个参与方知道该门的一个输入,因此称之为半门。两个半门分别为生成方半门(生成方知道其中一个输入)和计算方半门(计算方知道其中一个输入)。因为已知一个输入,所以半门的混淆表只包含两条密文,并且可以通过GRR3技术缩减到一条。最后,两个半门的输出通过免费的异或运算结合起来,得到整个与门的输出。
对于导线 \(w_i\),我们用 \(W_i^0\) 表示值0对应的标签。假设生成方半门要计算 \(v_\ell = v_i \wedge v_j\),其中生成方已知 \(v_i\) 的值。如果 \(v_i = 0\),则无论 \(v_j\) 为何值 \(v_\ell\) 一定为 0;如果 \(v_i = 1\),则 \(v_\ell = v_j\). 于是,(未经过排列的)混淆表构造如下:
其中,\(v_i \Delta\) 表示:当 \(v_i = 1\) 时,\(v_i \Delta = \Delta\),当 \(v_i = 0\) 时,\(v_i \Delta\) = \(0^\kappa\). 生成方根据 \(W_j\) 的标识比特对密文进行排列,并使用GRR技术缩减一条密文。当计算方对该半门进行计算时,如果其持有 \(W_j^0\),他将解密得到 \(W_\ell^0\);如果其持有 \(W_j^1\),他将解密得到 \(W_\ell^0 \oplus v_i \Delta\).
我们再考虑计算方半门。假设计算方半门要计算 \(v_\ell = v_i \wedge v_j\),其中计算方已知 \(v_i\) 的值。生成方不知道 \(v_i, v_j\) 中任何一个值,他构造如下的混淆表:
此时,生成方不能打乱密文的顺序。当计算方对该半门进行计算时,如果他知道 \(v_i = 0\),那么他就知道自己持有的是 \(W_i^0\),他解密第1行得到 \(W_\ell^0\);如果他知道 \(v_i = 1\),那么他就知道自己持有的是 \(W_i^1\),他首先解密第二行得到 \(W_\ell^0 \oplus W_j^0\),再将这个结果与他持有的 \(w_j\) 的标签计算异或。不难发现,当他持有 \(W_j^0\) 时,得到的输出标签是 \(W_\ell^0\);当他持有 \(W_j^1\) 时,得到的输出标签是 \(W_\ell^0 \oplus \Delta = W_\ell^1\),即这样计算的结果是正确的。同样地,生成方使用GRR技术缩减一条密文。
最后,与门的计算需要合并两个半门。对于某个与门 \(v_c = v_a \wedge v_b\),选取随机比特 \(r\),由于与操作对异或操作满足分配律,它可以表示为 \(v_c = (r \wedge v_a) \oplus ((r \oplus v_b) \wedge v_a)\). 因为 \(r\) 是生成方随机选取的,生成方知道 \(r\) 的值,因此左边的与门 \((r \wedge v_a)\) 是生成方半门。如果右边的与门 \(((r \oplus v_b) \wedge v_a)\) 能成为计算方半门,就完成了整个构造,但是这需要让计算方知道 \(r \oplus v_b\)(注意,\(r\) 是随机比特,\(r \oplus v_b\) 不会泄露任何信息)。这里采用的方式是将 \(r\) 设置为导线 \(w_b\) 值0对应的标识比特 \(p_b^0\)(标识比特本身就是随机选取的)。计算方持有 \(W_b^{v_b}\),他不知道 \(v_b\) 的值,但是 \(p_b^{v_b}\) 就等于 \(r \oplus v_b\)(当 \(v_b = 0\) 时,\(p_b^{v_b} = p_b^0 = r \oplus 0 = r \oplus v_b\);当 \(v_b = 1\) 时,\(p_b^{v_b} = p_b^1 = r \oplus 1 = r \oplus v_b\))。至此,生成方可以按照上文所述的方式分别构造生成方半门和计算方半门的混淆表,就完成了半门方案的构造。
其中,\(w_{G_c}\) 是生成方半门的输出导线,\(w_{E_c}\) 是计算方半门的输出导线。与上文中与门的例子类似,计算方将生成方半门的混淆表按照标识比特排列,不打乱计算方半门的混淆表,并通过GRR技术将混淆表缩减一行。
半门方案不仅同时实现了2行的混淆表和免费的异或计算,它的作者还证明了 [Zah et al., 2015]:任何线性类混淆电路方案(注:直观地说,“线性”指的是混淆电路的生成和计算(除去对随机谕示机的请求)所需要对称密码学(symmetric-key)操作数量与电路大小成线性关系。)中,奇门所需的密文数量不可能少于2个。因此,在线性假设下,半门方案是通讯开销最优的方案。
表 8.6对本节介绍的混淆电路优化方案进行了总结。
| \(\multirow{3}{*}{方案}\) | {2}{c}{\(\multirow{2}{*}{混淆表大小}\)} | 计算开销 | ||||
| \(\cline{4-7}\) | 生成 | 计算 | ||||
| 标识置换 [Bea et al., 1990] | 4 | 4 | 4 | 4 | 1 | 1 |
| \(4\rightarrow 3\)混淆表行缩减(GRR3) [Naor et al., 1999] | 3 | 3 | 4 | 4 | 1 | 1 |
| \(4\rightarrow 2\)混淆表行缩减(GRR2) [PSSW, 2009] | 2 | 2 | 4 | 4 | 1 | 1 |
| free-XOR + GRR3 [Kol & Sch, 2008] | 0 | 3 | 0 | 4 | 0 | 1 |
| 半门 [Zah et al., 2015] | 0 | 2 | 0 | 4 | 0 | 2 |
混淆电路优化方案及其开销。列在标识置换之后的方案同样采用了标识置换技术。混淆表大小以表中密文数量为度量,忽略额外的常数项;计算开销以调用加密/解密算法的次数为度量。
BMR协议
上一节介绍的姚氏混淆电路协议只适用于两个参与方的情形。如果希望拓展到 \(n\) 个参与方,其中每个参与方 \(P_i\) 拥有隐私输入 \(x_i\),他们希望安全地计算 \(f(x_1, …, x_n)\). 令 \(\mathcal{C}\) 是函数 \(f\) 所对应的布尔电路,我们可能有以下直观的想法。
\(P_1\) 生成混淆电路 \(G(\mathcal{C})\).
\(P_1\) 与其他参与方 \(P_2, …, P_n\) 执行OT协议,使 \(P_2, …, P_n\) 得到各自的输入所对应的标签(密钥)。
\(P_1\) 将混淆电路 \(G(\mathcal{C})\) 发给 \(P_2\),参与方 \(P_i, \; i \neq 2\) 将自己的输入所对应的标签发给 \(P_2\).
\(P_2\) 计算混淆电路,得到 \(f(x_1, …, x_n)\) 并将其广播。
不难看出,上述协议在只有一个参与方被攻陷的情况下确实是安全的。但是,如果 \(P_1\) 和 \(P_2\) 同时被攻陷,那么敌手就同时知道了生成混淆电路的秘密信息(标签与导线值的对应关系)和所有参与方的输入所对应的标签,因而可以获得所有参与方的输入。这样的安全性是无法令人满意的,我们希望协议能够与基于秘密分享的协议类似,存在一个门限值 \(t\),使得任意不超过 \(t\) 个参与方都不能从协议中获得任何额外信息。
不过,我们可以从这个直观想法中得到一些启发:协议不应该由某个参与方单独生成混淆电路,而应该由所有参与方共同生成混淆电路,使得任意不超过 \(t\) 个参与方都不能得到混淆电路的秘密信息(导线标签与导线值的对应关系)。之前的章节讲过,基于秘密分享的MPC协议(例如BGW、GMW)可以进行任意通用的计算。我们发现,混淆电路 \(G(\mathcal{C})\) 是关于所有导线标签的一个函数,而输入值对应的导线标签是关于参与方输入以及输入导线标签的函数。那么,通过秘密分享导线标签和输入值,应当可以分布式地生成混淆电路和输入值对应的导线标签。
协议基本思路如下。对于每条导线 \(w_i\),参与方 \(P_j\) 随机选择子标签 \(s_{i, j}^0, s_{i, j}^1\),定义 \(w_i\) 的标签 \(W_i^0 = s_{i, 1}^0 \oplus … \oplus s_{i, n}^0, \; W_i^1 = s_{i, 1}^1 \oplus … \oplus s_{i, n}^1\).(注:这里需要保证 \(W_i^0\) 和 \(W_i^1\) 的最后一位标识比特是相反的,可以通过以下方式实现:当参与方数量 \(n\) 为奇数时,要求所有参与方选取的 \(s_{i, j}^0, s_{i, j}^1\) 最后一位都相反;当参与方数量 \(n\) 为偶数时,要求 \(P_1\) 选取的 \(s_{i, 1}^0, s_{i, 1}^1\) 最后一位相同,其他参与方选取的 \(s_{i, j}^0, s_{i, j}^1 (j \neq 1)\) 最后一位相反。)然后参与方调用MPC协议(例如GMW)共同生成混淆电路。随后,参与方再对输入进行秘密分享,调用MPC协议共同计算输入值对应的导线标签。最后,每个参与方基于混淆电路和输入值的导线标签,计算混淆电路得到协议输出。
这样的协议确实使得不超过 \(n - 1\) 个被攻陷参与方无法获得额外信息,但是其效率是很低的。注意到,计算混淆电路时,对于门 \(g_i\),混淆表的每一项为 \(H(k_a^\alpha || k_b^\beta || i) \oplus ( k_c^{g_i(\alpha, \beta)} || p_c^{g_i(\alpha, \beta)} )\) 的形式,其中 \(H\) 是哈希函数。按照上述思路,\(k_a^\alpha, k_b^\beta\) 都是秘密分享的,那么参与方需要对其进行复杂的哈希计算,效率将非常低。也就是说,以上方式并不是共同生成混淆电路的“好的”方式。
直观思想
BMR(Beaver-Micali-Rogaway)协议 [Bea et al., 1990]展示了一种“更好的”方式,其思路是:对于每条导线 \(w_i\),参与方 \(P_j\) 随机选择子标签(又称为seed) \(s_{i, j}^0, s_{i, j}^1\),定义 \(w_i\) 的标签(又称为superseed) \(S_i^0 = s_{i, 1}^0 || … || s_{i, n}^0, \; S_i^1 = s_{i, 1}^1 || … || s_{i, n}^1\). 也就是说,标签是子标签的连接而不是异或。当使用 \(S_i^0\) 加密消息 \(M\) 时,将其实现为 \(M \bigoplus_{j=1}^n \mathcal{G}(s_{i, j}^0)\),其中 \(\mathcal{G}\) 是伪随机数生成器(pseudo-random generator, PRG)。这样一来,参与方 \(P_j\) 可以在本地计算 \(\mathcal{G}(s_{i, j}^0)\),然后将其作为底层MPC协议的输入,计算混淆表,计算过程只需要对秘密分享的值进行简单的异或计算即可,大大提升了运行效率。
然而,这样的构造中,从 \(P_j\) 的视角看,每个标签中有一段子标签是 \(P_j\) 贡献的,因此他可以知道标签对应的值是0还是1,这将直接泄露导线上的秘密值!
为了解决这个问题,BMR协议为每一条导线 \(w_i\) 均匀随机选取掩码比特(masking bit) \(\lambda_i\),它掩盖了导线的真实值(real value) \(v_i\),使得参与方只能知道导线的外部值(external value) \(p_i\). 三者满足 \(p_i = v_i \oplus \lambda_i\). 由于 \(\lambda_i\) 是均匀随机选择的,所以外部值不会泄露真实值。下面,我们进行更详细的阐述。
看待标识置换的另一种视角。之前介绍标识置换技术时,我们说标识置换为每一个密钥附加了一个标识比特。对于导线 \(w_a\),密钥 \(k_a^0\) 附带了 \(p_a^0\),密钥 \(k_a^1\) 附带了 \(p_a^1\),且 \(p_a^0 = 1 - p_a^1\). 在计算混淆电路时,计算方持有 \(w_a\) 的一个标签 \(k_a || p_a\),他并不知道标签对应的真实值,但是他能看到标识比特 \(p_a\),因此,\(p_a\) 可以看成导线 \(w_a\) 的外部值(计算方可以看到的值)。外部值与真实值有两种可能的关系:相等或相反。由此可以定义掩码比特 \(\lambda_a\). 如果 \(\lambda_a = 0\),那么外部值等于真实值;如果 \(\lambda_a = 1\),那么外部值等于1减真实值。如果将 \(w_a\) 的真实值记为 \(v_a\),外部值记为 \(p_a\),掩码比特记为 \(\lambda_a\),它们满足 \(p_a = v_a \oplus \lambda_a\). 也就是说,在这种视角下,我们把标识比特 \(p_a\) 看作导线的外部值,并定义掩码比特 \(\lambda_a\).
接下来,让我们看看BMR协议中混淆表的构造方式。首先,对于每条导线 \(w_i\),每个参与方 \(P_j, \; j \in [n]\) 随机选择两个子标签(seed) \(s_{i, j}^0, s_{i, j}^1 \leftarrow_{\$} \{0, 1\}^\kappa\) 以及随机比特 \(\lambda_{i, j} \leftarrow_{\$} \{0, 1\}\). 子标签 \(s_{i, j}^0, s_{i, j}^1\) 分别对应导线的外部值0和1. 请注意,这里 \(s_{i, j}^0\) 对应的是外部值0,而在之前章节使用的符号中,\(k_i^0\) 或 \(W_i^0\) 对应的是真实值0,请读者注意这里的符号区别。定义 \(w_i\) 的标签(superseed)为 \(S_i^0 = s_{i, 1}^0 || … || s_{i, n}^0 || 0, \; S_i^1 = s_{i, 1}^1 || … || s_{i, n}^1 || 1\),定义 \(w_i\) 的掩码比特为 \(\lambda_i = \lambda_{i, 1} \oplus … \oplus \lambda_{i, n}\). 也就是说,标签是子标签的连接再连接上外部值(标识比特)(注:我们在标签的最后附加了它的外部值,但是对于生成混淆电路的参与方来说,其实无需这么做,因为对于 \(P_j\) 来说,每个标签中有一段子标签是他自己选取的,因此他能够知道对应的外部值。我们仍然在标签后附加外部值的原因是,这使得生成的混淆电路可以由任何人计算,即使他没有参与混淆电路的生成。),而掩码比特由所有参与方秘密分享。
混淆表通过如下方式构造。令 \(\mathcal{G}: \{0, 1\}^\kappa \rightarrow \{0, 1\}^{2 n \kappa + 2}\) 是输入长度为 \(\kappa\),输出长度为 \(2 n \kappa + 2\) 的伪随机数生成器(见「伪随机数生成器」一节)。定义 \(g_{i, j}^p = \mathcal{G}(s_{i, j}^p)[1 : n \kappa +1], \; h_{i, j}^p = \mathcal{G}(s_{i, j}^p)[n \kappa +2 : 2 n \kappa + 2]\),即 \(g_{i, j}^p\) 是伪随机数生成器的前一半输出,\(h_{i, j}^p\) 是后一半输出。对于布尔门 \(g\),假设其输入导线为 \(w_a, w_b\),输出导线为 \(w_c\),其混淆表如下。
让我们分析一下混淆表为什么这样构造。首先,这里的 \(A_g\) 是用 \(S_a^0\) 和 \(S_b^0\) 加密 \(S_c^0\)(或 \(S_c^1\))得到的密文,\(B_g\) 是用 \(S_a^0\) 和 \(S_b^1\) 加密得到的密文,\(C_g, D_g\) 也同理。 混淆表应当根据标识比特(即外部值)进行排列,而这里 \(S_a^0, S_b^0, S_c^0\) 对应的就是外部值0(再次强调,之前章节中的 \(k_a^0\) 和 \(W_a^0\) 对应的是真实值0,请一定注意符号区别),因此,混淆表 \((A_g, B_g, C_g, D_g)\) 已经正确地排列了。其次,混淆表需要确保计算方得到导线 \(w_c\) 的正确标签,即真实值 \(v_a, v_b, v_c\) 应当满足 \(g(v_a, v_b) = v_c\). 由于真实值、外部值、掩码比特满足 \(p_a = v_a \oplus \lambda_a\),我们有
对于混淆表的第一项 \(A_g\),它对应于外部值 \(p_a = 0, p_b = 0\) 的情况,因此当 \(g(\lambda_a, \lambda_b) = \lambda_c\) 时,\(p_c = 0\),计算方应该获得导线 \(w_c\) 外部值0对应的标签 \(S_c^0\);当 \(g(\lambda_a, \lambda_b) \neq \lambda_c\) 时,\(p_c = 1\),计算方获得导线 \(w_c\) 外部值1对应的标签 \(S_c^1\). 对于混淆表的第二项 \(B_g\),它对应于外部值 \(p_a = 0, p_b = 1\) 的情况,因此当 \(g(\lambda_a, \overline{\lambda_b}) = \lambda_c\) 时,\(p_c = 0\),计算方应该获得导线 \(w_c\) 外部值0对应的标签。\(C_g, D_g\) 的构造也同理。换句话说,混淆表本质上仍是姚氏混淆电路的混淆表,区别是:(1) 符号表示有所不同,这里 \(S_i^0\) 的上标代表外部值;(2) 加密方式有所不同,当使用 \(S_i^0\) 加密消息 \(M\) 时,将其实现为 \(M \bigoplus_{j=1}^n \mathcal{G}(s_{i, j}^0)\),并且由于每个标签需要加密混淆表中的两项,我们不能重复使用PRG的输出(注:如果重复使用了PRG的输出异或不同的消息 \(M_1, M_2\),那么将得到密文 \(C_1 = M_1 \oplus \mathcal{G}(S_i^p), C_2 = M_2 \oplus \mathcal{G}(S_i^p)\). 参与方可以计算 \(C_1 \oplus C_2 = M_1 \oplus M_2\). 这就形成了two-time pad问题。),因此需要取 \(g_{i, j}^p = \mathcal{G}(s_{i, j}^p)[1 : n \kappa +1], \; h_{i, j}^p = \mathcal{G}(s_{i, j}^p)[n \kappa +2 : 2 n \kappa + 2]\) 分别为PRG输出的前一半和后一半。
以及布尔门类型的函数,因此参与方可以调用MPC协议(例如BGW、GMW)安全地计算所有混淆表。
最后,协议还需要计算输入值对应的标签,以及解密输出值。对于每条输入导线 \(w_i\),其值 \(v_i\) 是某个参与方的输入。该参与方将 \(v_i\) 秘密分享,然后所有参与方安全地计算 \(w_i\) 的外部值 \(p_i = v_i \oplus \lambda_i\)(\(\lambda_i\) 也是被秘密分享的)并公布。然后,每个参与方 \(P_j\) 广播 \(s_{i, j}^{p_i}\). 标签 \(S_i^{p_i} = s_{i, 1}^{p_i} || … || s_{i, n}^{p_i} || p_i\) 即为该输入导线的标签。根据输入导线的标签,计算方可以按照拓扑顺序解密每个混淆表,得到所有输出导线的外部值。设某条输出导线为 \(w_j\),计算方得到了它的外部值 \(p_j\),所有参与方恢复出该输出导线的掩码比特 \(\lambda_j\),于是,\(v_j = p_j \oplus \lambda_j\) 就是该输出导线的值。
协议描述
轮数复杂度(round complexity)。之前章节介绍的基于秘密分享的协议(例如BGW、GMW),每个乘法门(或与门)都需要参与方之间的交互。协议由输入层向输出层一层层地计算,因此,协议的轮数与电路的深度成线性关系。不过,对于姚氏混淆电路协议和BMR协议,它们的轮数复杂度是常数!即协议轮数与电路的深度无关。我们对此做一个简单的分析。
在姚氏混淆电路协议中,电路生成方 \(P_1\) 和计算方 \(P_2\) 的交互包括:(1) \(P_1\) 向 \(P_2\) 发送混淆电路;(2) 对于 \(P_2\) 的每个输入比特,\(P_1\) 与 \(P_2\) 执行OT协议;(3) \(P_2\) 将协议输出发给 \(P_1\). 其中,(1)和(3)各需要一轮,而(2)中的OT协议可以并行执行,无论 \(P_2\) 的输入有多长,协议轮数都是常数(它等于OT协议的轮数+2)。
对于BMR协议(如图 8.4和图 8.5所示),参与方的交互包括:将输入比特秘密分享(步骤1);计算每个门的混淆表(步骤3);计算每条输入导线的标签(步骤4)。步骤1的秘密分享可以并行执行,只需1轮。我们着重分析步骤3和4. 可以发现,无论电路规模有多大,门的混淆表和输入导线的标签都可以并行地计算。特别地,对于门 \(g\) 的混淆表(假设其输入导线为 \(w_a, w_b\),输出导线为 \(w_c\)),它只与 \(\{ g_{i, j}^0, h_{i, j}^0, g_{i, j}^1, h_{i, j}^1, \lambda_{i, j} \}_{i \in \{a, b, c\}}\) 和门的类型有关,与其他门的输入输出无关。而 \(\{ g_{i, j}^0, h_{i, j}^0, g_{i, j}^1, h_{i, j}^1, \lambda_{i, j} \}_{i \in \{a, b, c\}}\) 是由参与方在步骤2中选择的随机子标签和随机比特定义的。因此,步骤3中的每个混淆表都可以并行地计算,只需要常数轮(取决于计算混淆表的电路与底层的MPC协议 \(\Pi\))。整个BMR协议也只需要常数轮的交互。实际上,BMR的原始论文 [Bea et al., 1990]的题目是The Round Complexity of Secure Protocols,文章重点从理论上论证了:常数轮安全多方计算协议是存在的。
姚氏混淆电路协议和BMR协议只需常数轮交互的特点,使其在网络延迟较大的场景下,与基于秘密分享的协议相比常常具有性能优势。
安全性分析
最后,我们分析一下BMR协议的安全性。由于在计算混淆表时调用了底层MPC协议 \(\Pi\),因此BMR协议的安全性基于 \(\Pi\) 的安全性。
模拟器 \(\mathcal{S}\) 的构造如下。
步骤1中,\(\mathcal{S}\) 模拟诚实方以0为输入进行秘密分享。
步骤3中,\(\mathcal{S}\) 调用底层MPC协议 \(\Pi\) 的模拟器 \(\mathcal{S}_\Pi\),使得步骤3输出的是一个“假的”混淆电路 \(\tilde{G}(\mathcal{C})\).(注:读者可以回顾BGW协议、GMW协议的模拟器,它可以基于协议输出模拟被攻陷方的视图。因此这里可以调用 \(\mathcal{S}_\Pi\) 使步骤3输出 \(\tilde{G}(\mathcal{C})\).) 它无论输入导线的标签是什么,输出总是 \(f(x_1, …, x_n)\). \(\tilde{G}(\mathcal{C})\) 的构造思路与定理 8.1完全类似,这里不再赘述。
步骤4中,\(\mathcal{S}\) 模拟诚实方遵循协议计算输入导线的标签。
不难发现,由于“假的”混淆电路 \(\tilde{G}(\mathcal{C})\) 与真实的混淆电路是不可区分的(详细证明可参考定理 8.1),\(\mathcal{S}\) 模拟的视图与真实的视图不可区分。
BMR协议重点论证了常数轮MPC协议的存在性。假设步骤3使用的是BGW协议,那么被攻陷方数量不能超过 \(t\), \(t < n/2\). 此时,BMR协议只需要假设伪随机数生成器存在(以及安全信道,这是基本假设),就实现了常数轮的MPC协议。
本章思考题
姚氏混淆电路协议中的对称加密算法和随机谕示机有哪些高效的实现方式?这些实现方法在应对大规模(亿级)门电路时是否引入了额外的安全风险?
姚氏混淆电路协议和BMR协议都是常数轮复杂度的多方安全计算协议。请问常数轮协议在哪些实际应用场景具有优势?
如果一个安全多方计算协议将会在虚拟机上运行,假设敌手可以任意暂停或者倒带(rewind)此虚拟机,这对协议的安全性提出了哪些要求?
学习笔记
记录协议细节、模拟器构造与图中记号对照。